现在的 AI Video 工具,已经能够生成相当漂亮的单个镜头。
每次看到 AI 短剧的某个片段,我都会忍不住感慨:人物的神态、画面的光影、镜头的构图,甚至人物的动作,都越来越接近真实拍摄的效果。
但有意思的是,我在看一些 AI 短剧切片时,也经常能发现一些明显的穿帮镜头。上一秒背景里还有几个人,下一秒就消失了;刚刚还是夏天的街道,转眼间就有了秋天的景象。奇怪的是,只要剧情足够吸引人,我似乎也能忽略这些问题。
这让我意识到,单个镜头的画面质量和多个镜头之间的连贯性,其实是两回事。
一个镜头足够精彩,能够吸引观众的注意力。但当我们试图用多个镜头讲述一段完整的故事时,画面之间的关系就变得重要起来。
一个厨房里的例子
比如,一个女孩在厨房里做饭。
第一个镜头,她站在窗边切菜。阳光从左侧照进来,桌子在她身后。
第二个镜头,她转身走向冰箱。
第三个镜头,她拿起桌上的杯子,坐在餐桌旁。
单独看这三个镜头,可能都很漂亮。但如果第二个镜头里的冰箱跑到了窗户旁边,第三个镜头里的餐桌又换了一个方向,观众就会隐约觉得哪里不对。
问题并不只是画面发生了变化,而是我们对这个空间的认知被打断了。
预先存在的空间
看一部真实拍摄的电影时,我们通常不会刻意记住房间里每一件家具的位置。但当人物从门口走向餐桌,或者从沙发旁拿起一个杯子时,我们能够自然地理解这些动作发生在同一个空间里。
这是因为电影中的空间通常是预先存在的。摄影机可以从不同角度拍摄,人物可以在其中自由活动,镜头虽然变化,空间关系却相对稳定。
而在很多 AI 视频工作流中,情况恰好相反。
每次生成一个镜头,模型都需要根据提示词、参考图像等信息,重新构建一个看起来合理的画面。它可能生成一间很漂亮的厨房,却不一定知道上一镜头里窗户、餐桌和冰箱的准确位置。
于是,镜头之间就可能出现各种细微甚至明显的变化。
窗户的位置偏移了,桌椅的距离发生了变化,人物走向某个物体时,原本合理的空间关系也不再成立。
如果只是一个独立的画面,这些差异未必影响观感。但在连续叙事中,它们会逐渐累积,最终影响观众对整个场景的信任。
场景一致性不只是背景一样
所以,场景一致性并不只是让背景看起来一样。它还涉及空间布局、物体位置、人物与环境的关系,以及摄像机在这个空间里的运动。
这也让我开始思考:与其在每次生成镜头时反复描述一个空间,不如先把这个空间建立起来。
用 Samelab 搭建一个场景
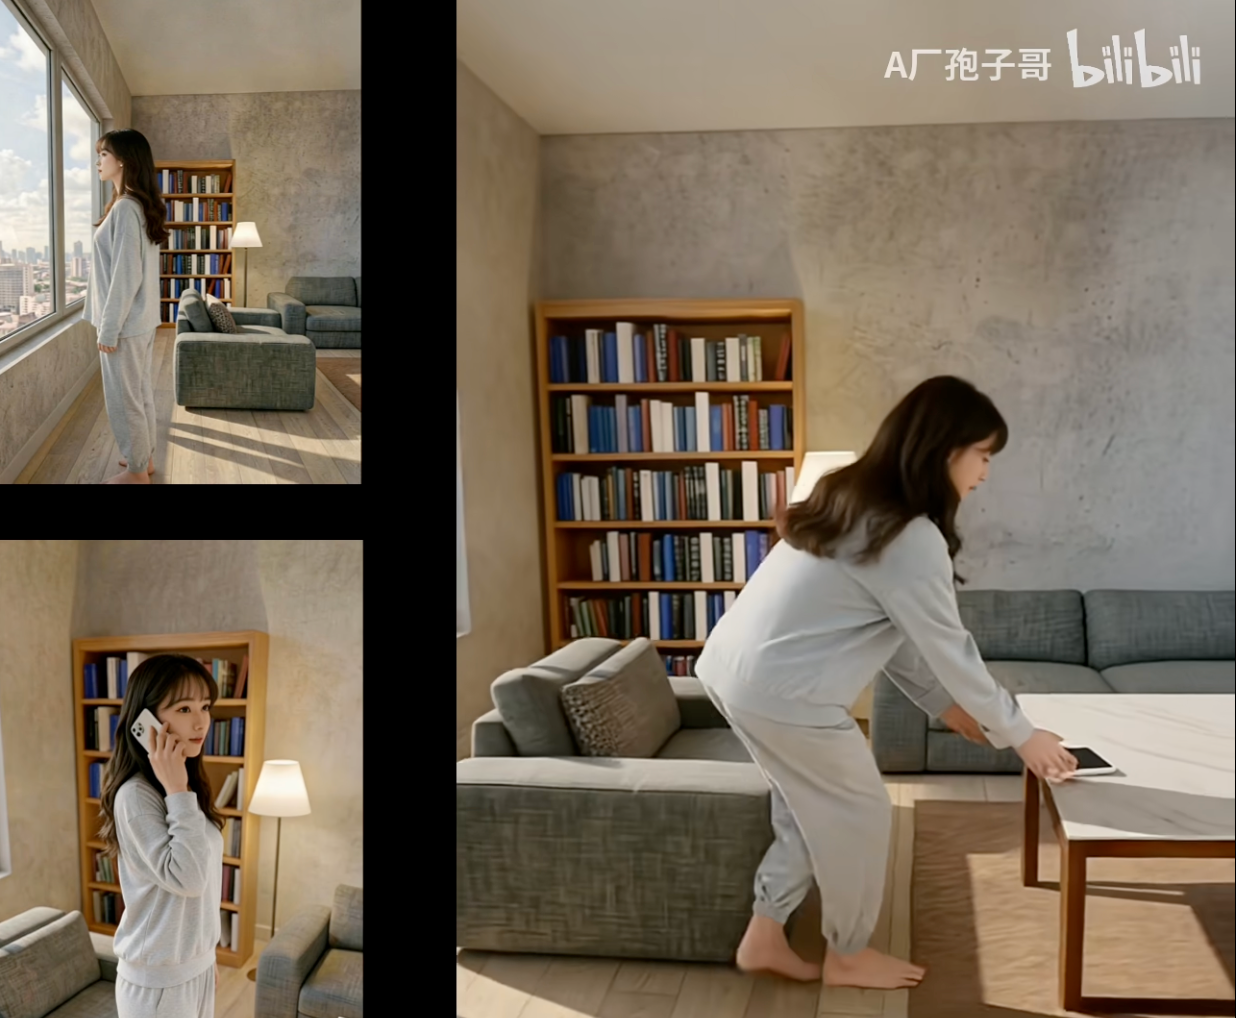
最近,我们尝试用 Samelab 搭建了一个刚才描述的姑娘活动的画面。
我们先确定窗户、沙发、茶几、书柜等物体的位置,再通过调整摄像机的角度和距离,获得不同方向的场景视图。这样一来,多个镜头就不再完全依赖文字描述来重新构建空间,而是有了一个共同的场景基础。
一个起点,而不是终点
当然,这并不意味着问题已经彻底解决。
当我们把场景导出到其他 AI 视频工具中,模型依然可能重新绘制部分细节,人物动作也可能与空间发生偏差。但至少在场景布局和摄像机视角的控制上,我们有了一个相对明确的起点。
这次尝试让我越来越觉得,AI 视频创作正在面临一个值得关注的变化:当生成漂亮画面逐渐变得容易,如何组织这些画面,让它们共同构成一个可信的世界,可能会成为新的挑战。
毕竟,观众看一部电影,不只是看一组漂亮的画面,更是在相信一个连续发生的故事。如果真的要 AI 视频取代实拍电影,那么场景一致性问题就是个非常值得探讨和投入的事情。